Distancia de Fermat · Parte 1 de 14
La tesis en un post: distancia de Fermat para clasificar
Esta serie adapta mi tesis de maestría en Estadística Matemática (UBA), «Distancia de Fermat en Clasificadores de Densidad por Núcleos», dirigida por Pablo Groisman. Este primer post es la tesis entera en pocas líneas: de dónde salió, qué se preguntó, qué encontró y un mapa para leer el resto. Se puede leer solo; los demás profundizan cada pieza.
Introducción
Hace un lustro, cuando ya salíamos a hacer las compras sin barbijos pero la educación seguía siendo fundamentalmente a distancia en los últimos estertores de la pandemia del covid, me anoté a una optativa del departamento de matemática para completar el programa de la maestría en estadística. Al igual que los otros 120 alumnos inscriptos, le vi nombre de materia práctica, pero resultó ser un paseo para nada aleatorio sobre tópicos de probabilidad, con tangenciales menciones a aplicaciones de aprendizaje automático. Tan «áspera» resultó para los que no veníamos de la licenciatura en matemática, que solo una décima parte de los inscriptos la cursamos hasta el final, y versiones más recientes del mismo curso llevan el siguiente descargo justo por encima del programa:
Esta es una materia de matemática, más precisamente de probabilidad. Vamos a probar teoremas y todo eso (pero no sólo eso!). Los problemas que trataremos están motivados por cuestiones relativas al aprendizaje automático (ML), pero vamos a hacer matemática. Ya enterados, si siguen con ganas, son todes bienvenides!
— del sitio de probabilidad y machine learning (2024)
Quienes nos quedamos hasta el final tuvimos la oportunidad de estudiar con riguroso fundamento matemático fenómenos «folclóricos» del análisis estadístico como la «maldición de la dimensionalidad», aprender marcos teóricos sólidos para áreas de frontera del aprendizaje automático como las redes neuronales [1] y el aprendizaje de variedades [2], y «mojar los pies» en el análisis de elementos aleatorios definidos en espacios de probabilidad no reducibles a como grafos, procesos puntuales y paseos al azar.
Encantado con el programa, le pregunté al docente a cargo si no tenía algún tema de investigación asequible a una tesis de maestría, y me contestó que sí. De las conversaciones posteriores surgió la idea de aplicar la «distancia de Fermat» [3] al problema de clasificación en altas dimensiones. Las páginas que siguen están escritas en el mismo espíritu curioso e indagador de aquella materia que lo disparó. En los preliminares — de la segunda a la séptima parte — comenzamos por definir las dificultades de la clasificación en alta dimensión, pero en lugar de ir «hacia adelante» a posibles soluciones, primero hacemos un recorrido preliminar en la dirección opuesta: hacia explicaciones posibles de lo desafiante del problema de clasificación en alta dimensión, y hacia el desarrollo histórico de los métodos estadísticos — estimación de densidad por núcleos — y la teoría matemática — densidad en variedades riemannianas compactas sin frontera — que subyacen a los algoritmos de clasificación novedosos basados en distancia de Fermat que proponemos en la octava parte. En la novena definimos también los experimentos y el proceso de evaluación de las bondades relativas de tales clasificadores, mientras que de la décima a la decimotercera analizamos los resultados obtenidos. En la última recapitulamos lo obtenido: como es de esperar, el método propuesto ofrece ventajas marginales sobre métodos equivalentes entrenados con distancia euclídea, pero solo en escenarios particulares, que intentamos caracterizar a partir de lo observado. Finalmente, proponemos algunas líneas de trabajo futuro a priori prometedoras.
En una época absolutamente obsesionada por la inteligencia artificial y los agentes, donde la red neuronal profunda parece ser la reina del aprendizaje automático, perseguir un resultado de mejora marginal en escenarios específicos para un método clásico puede parecer irrelevante. Este texto no fue escrito para «empujar la frontera», sino para disfrutar del humano placer de aprender en profundidad un tema, y compartir con los demás lo aprendido. Espero que leer estas páginas les genere una fracción del placer que a mí me da presentárselas.
La tesis en un párrafo
Este es el resumen de la tesis, tal como fue presentado:
En altas dimensiones, la distancia natural del espacio en que se registran las observaciones de un elemento aleatorio — típicamente la distancia euclídea en — no distingue adecuadamente entre elementos en la vecindad local de una observación y otros más alejados, lo cual dificulta enormemente cualquier tarea de clasificación basada en distancias. Según la «hipótesis de la variedad», los elementos aleatorios bajo estudio podrían posarse sobre una variedad de dimensión intrínseca potencialmente mucho menor que la ambiente — la del soporte de registro —, y en tal contexto sería posible aprender una distancia de los datos que conserve utilidad en alta dimensión. Habiendo analizado la genealogía y los fundamentos teóricos del aprendizaje de distancias, proponemos un clasificador basado en densidad por núcleos para elementos aleatorios definidos en variedades riemannianas compactas, sin frontera y a priori desconocidas, utilizando la distancia de Fermat aprendida de los datos disponibles, y aplicamos la misma distancia al clasificador de vecinos más cercanos. El estudio sistemático de estas construcciones revela que los clasificadores basados en densidad son competitivos frente a métodos del estado del arte, sin que ninguno domine con claridad. En datasets de alta curvatura y poca separación entre clases, clasificadores entrenados con distancia de Fermat aportan mejoras en términos de sobre sus pares con distancia euclídea, sin perder en exactitud. En escenarios bien muestreados, donde la ventana del clasificador es pequeña y define un vecindario dentro del radio de inyectividad de la variedad, la distancia de Fermat no se diferencia de la euclídea y el beneficio es casi nulo. Por último, la distancia de Fermat es tan sensible a la escala de los atributos como la euclídea: en datasets con unidades heterogéneas, estandarizar es indispensable para que los clasificadores basados en distancias sean competitivos.
Dos figuras condensan el aporte. La primera muestra lo que la distancia de Fermat permite hacer: en dos hélices entrelazadas, el vecindario euclídeo de un punto pronto incorpora la otra hélice, mientras que el vecindario de Fermat crece a lo largo de la hebra, de modo que -KN se mantiene cerca de su óptimo para cualquier cantidad de vecinos .
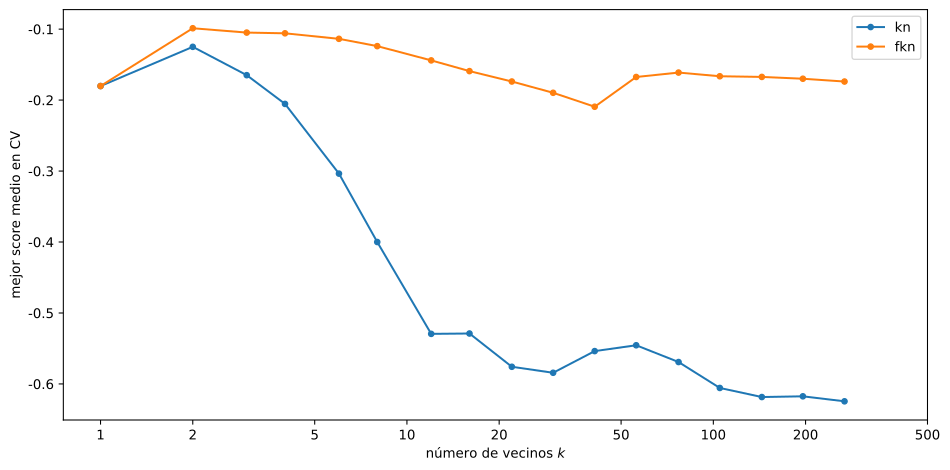
helices_0. Para cada , se muestra el mejor desempeño hallado entre todas las parametrizaciones de cada clasificador; -KN y su «dominio ampliado» vía igualan o superan a KN para todo . Detalles en la parte 12.La segunda muestra su límite más prosaico: la distancia de Fermat se construye sobre aristas euclídeas, así que hereda la sensibilidad a la escala de los atributos. En pinguinos, una variable en gramos frente a tres en milímetros hunde a toda la familia de métodos basados en distancias, y estandarizar la devuelve al nivel del mejor.
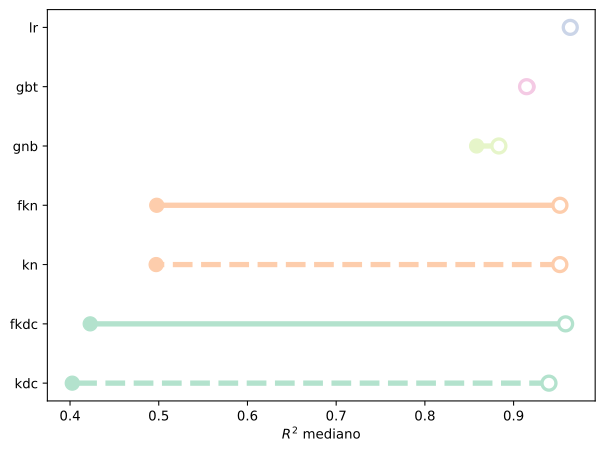
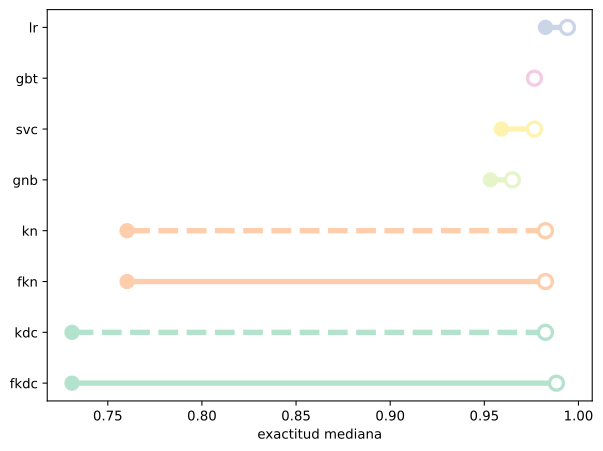
pinguinos sobre los atributos crudos (punto lleno) y estandarizados en el entrenamiento (punto vacío). Detalles en la parte 13.Cómo leer la serie
Cada parte responde una pregunta y se puede leer sola. Las partes 4 a 7 son las más matemáticas: quien solo quiera la intuición puede leer la 2 y la 3 y saltar a la propuesta quien solo quiera los resultados puede ir directo a la parte 10.
| Parte | Post | Pregunta | Nivel |
|---|---|---|---|
| 2 | Clasificar estimando densidades | ¿Cómo se construye un clasificador a partir de estimar densidades? | general |
| 3 | La maldición de la dimensionalidad y la hipótesis de la variedad | ¿Por qué falla en alta dimensión, y por qué aun así funciona? | general |
| 4 | Variedades de Riemann, lo justo y necesario | ¿Qué es, exactamente, una variedad? | matemático |
| 5 | Estimar densidades (y clasificar) sobre una variedad | ¿Se puede estimar una densidad sobre una variedad? | matemático |
| 6 | Cuando la variedad es desconocida: aprender la distancia | ¿Y si no conocemos la variedad? | técnico |
| 7 | Distancias basadas en densidad y la distancia de Fermat | ¿Qué distancia respeta la densidad de los datos? | matemático |
| 8 | La propuesta: clasificadores con distancia de Fermat | ¿Qué construimos, exactamente? | técnico |
| 9 | Cómo comparamos clasificadores | ¿Cómo se compara con justicia un clasificador nuevo? | técnico |
| 10 | Resultados I: el marcador global y las curvas en el plano | ¿Quién gana, y dónde? | resultados |
| 11 | Resultados II: ¿de dónde sale la ventaja de -KDC? | ¿Es la distancia de Fermat o es otra cosa? | resultados |
| 12 | Resultados III: hélices, hueveras y otras variedades en 3D | ¿Cuándo aporta algo propio la distancia de Fermat? | resultados |
| 13 | Resultados IV: datasets «orgánicos» | ¿Qué pasa con datos reales? | resultados |
| 14 | Conclusiones y próximos pasos | ¿Cuándo conviene, y qué queda por hacer? | general |
El código que acompaña la tesis está en github.com/capitantoto/fermat.
Referencias
- [1] Y. LeCun, Y. Bengio, y G. Hinton, «Deep Learning», Nature, vol. 521, n.º 7553, pp. 436-444, may 2015, doi: 10.1038/nature14539.
- [2] Y. Bengio, A. Courville, y P. Vincent, «Representation Learning: A Review and New Perspectives», IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 35, n.º 8, pp. 1798-1828, ago. 2013, doi: 10.1109/TPAMI.2013.50.
- [3] P. Groisman, M. Jonckheere, y F. Sapienza, «Nonhomogeneous Euclidean First-Passage Percolation and Distance Learning», Bernoulli, vol. 28, n.º 1, feb. 2022, doi: 10.3150/21-BEJ1341.