Distancia de Fermat · Parte 5 de 14
Estimar densidades (y clasificar) sobre una variedad
Probabilidad en variedades
Hemos definido una clase bastante general de variedades — las variedades de Riemann — capaces de soportar funciones de densidad y sus estimaciones [1]. Estos desarrollos relativamente modernos no constituyen el origen de la probabilidad en variedades. Mucho antes de su sistematización, ciertos casos particulares fueron ya bien estudiados y allanaron el camino para el interés en variedades más generales.
Probablemente la referencia más antigua a un elemento aleatorio en una variedad distinta a se deba a Richard von Mises, en Sobre la naturaleza entera del peso atómico y cuestiones relacionadas [2]1. En él, von Mises se plantea si los pesos atómicos — que empíricamente se observan siempre muy cercanos a la unidad para los elementos más livianos — son enteros con un cierto error de medición, y argumenta que para tal tratamiento, el «error gaussiano» clásico es inadecuado:
[] Pues no es evidente desde el principio que, por ejemplo, para un peso atómico de (Cl), el error sea de y no de : es muy posible que se logre una mejor concordancia con ciertos supuestos con la segunda determinación. A continuación, se desarrollan los elementos — esencialmente muy simples — de una «teoría del error cíclico», que se complementa con la teoría gaussiana o «lineal» y permite un tratamiento completamente inequívoco del problema de la «enteridad» y cuestiones similares.
— traducido de [2]
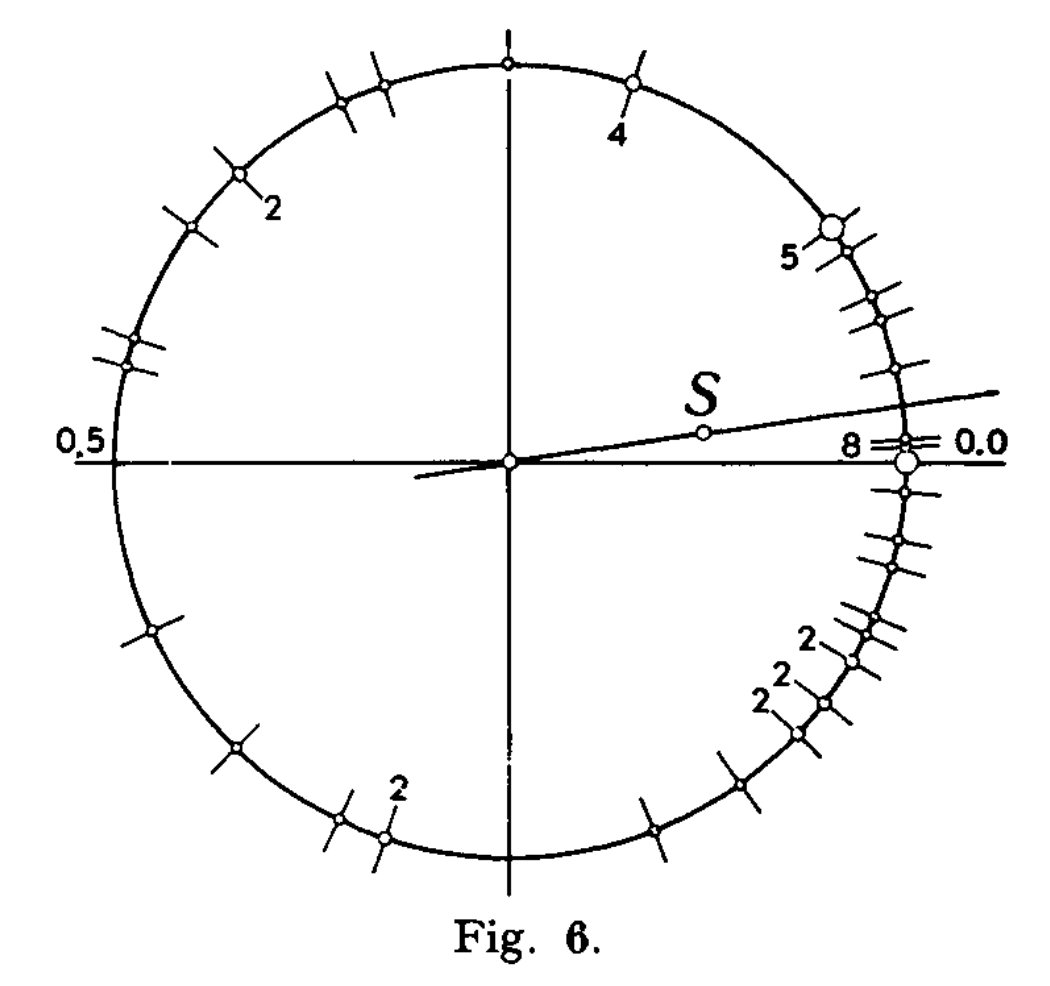
Motivado también por un problema del mundo físico, Ronald Fisher escribe «Dispersiones en la esfera» [3], donde desarrolla una teoría apropiada para mediciones de posición en una esfera2 y la ilustra a partir de mediciones de la dirección de la «magnetización termorremanente» de flujos de lava en Islandia.3
Dos décadas más tarde, los casos particulares de von Mises () y Fisher () fueron integrados al caso más general en lo que se conocería como «estadística direccional»4. En 1975 se habla ya de teoría de la distribución para la distribución von Mises–Fisher [4], la «más importante en el análisis de datos direccionales». A fines de los '80 Jupp y Mardia plantean «una visión unificada de la teoría de la estadística direccional» [5], adaptando conceptos clave del «caso euclídeo» como las familias exponenciales y el teorema central del límite, entre otros.
Aunque el caso particular de la -esfera sí fue bien desarrollado a lo largo del siglo XX, no se alcanzó un tratamiento más general de la estadística en variedades riemannianas conocidas pero arbitrarias.
KDE en variedades de Riemann
Ya en el siglo XXI, Bruno Pelletier propone una adaptación directa del estimador de densidad por núcleos multivariado (ver tercera parte) en variedades de Riemann compactas sin frontera [1]. Lo presentamos primero y ampliamos los detalles a continuación.
Definición (KDE en variedades de Riemann [1, Ecuación 1]). Sean
- una variedad de Riemann compacta y sin frontera de dimensión intrínseca , y la distancia de Riemann5,
- un núcleo isotrópico en soportado en la bola unitaria en y
- dados , la función de densidad de volumen en .
Sea una muestra de observaciones de una variable aleatoria con densidad soportada en . Luego, el estimador de densidad por núcleos para es la que a cada le asocia el valor
(1)
con la restricción de que la ventana , el radio de inyectividad de 6. El autor prueba la convergencia en :
Teorema (convergencia de en [1, §3 Teorema 5]). Sea una densidad de probabilidad dos veces diferenciable en con segunda derivada covariante acotada. Sea el estimador de densidad definido en la definición de KDE en variedades de Riemann con ventana . Luego, existe una constante tal que
(2)
En consecuencia, para , tenemos
(3)
Nótese que esta formulación sugiere en qué orden comenzar la búsqueda de un «óptimo». Guillermo Henry y Daniela Rodríguez prueban la consistencia fuerte de [7, Teorema 3.2]: bajo los mismos supuestos de [1], obtienen que
(4)
Definición (núcleo isotrópico). Sea un mapa no negativo tal que:
| es función de densidad en | |
| Si | |
| Si | |
| se maximiza en el origen |
Decimos entonces que el mapa es un núcleo isotrópico en soportado en la bola unitaria.
Definición (función de densidad de volumen [8, §6.2]). Sean ; le llamaremos función de densidad de volumen en a
(5)
Observación.
está bien definida «cerca» de : vale y cuando . Ciertamente está definida para todo dentro del radio de inyectividad de , 7.
El mapa exponencial alrededor de es un difeomorfismo en cierta bola normal alrededor de , así que admite una inversa continua y biyectiva al menos en tal bola ; lo notaremos
(6)
. Así, es la representación de en las coordenadas localmente euclídeas del espacio tangente a (o sencillamente «locales a «). De esta cantidad , queremos conocer el cociente entre dos medidas:
- la medida canónica de la métrica pullback de : la métrica inducida en por la métrica riemanniana en , y
- la medida de Lebesgue en la estructura euclídea de .
En otras palabras, representa cuánto se infla/encoge el espacio en la variedad alrededor de , relativo al volumen «natural» del espacio tangente. En general, su cómputo resulta sumamente complejo, salvo en casos particulares como las variedades «planas» o de curvatura constante.
Densidad de volumen en la esfera
Una variedad plana tiene curvatura8 nula en todo punto. De entre las variedades curvas, las -esferas son de las más sencillas, y tienen curvatura positiva y constante. Esta estructura vuelve posible el cómputo de en .
En Kernel Density Estimation on Riemannian Manifolds: Asymptotic Results [7], Guillermo Henry y Daniela Rodríguez estudian algunas propiedades asintóticas del estimador de KDE en variedades de Riemann, y las ejemplifican con datos de sitios volcánicos en la superficie terrestre. Para ello, desarrollan en y llegan a que9
(7)
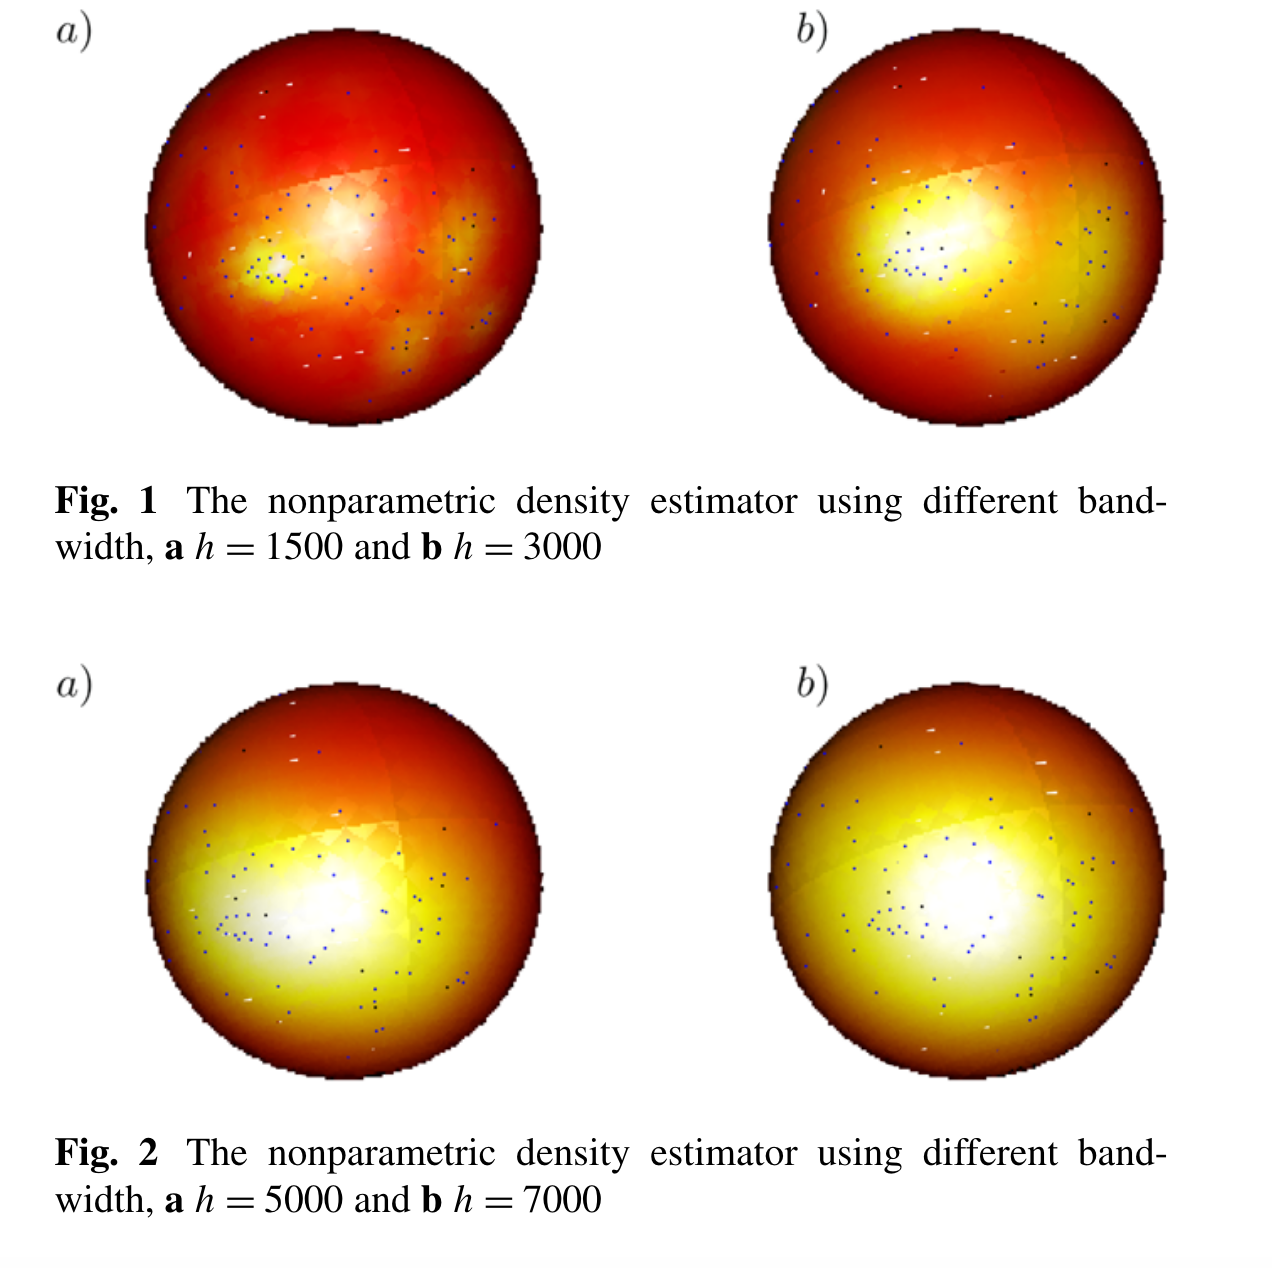
Para variedades de curvatura variable, el cálculo es mucho más complejo. En un trabajo reciente, por ejemplo, se reseña:
Un problema restante a esta altura es el de entender cómo la regularidad10 de afecta las tasas de convergencia de funciones suaves. en dimensión al menos, la regularidad de la variedad no afecta la tasa para estimar aun cuando es desconocida. Sin embargo, la función de densidad de volumen no es constante tan pronto como y obtener un panorama global en mayores dimensiones es todavía un problema abierto y presumiblemente muy desafiante.
— [9, §1.2, «Resultados Principales»]
Clasificación en variedades
Un desarrollo directo del estimador de KDE en variedades de Riemann consta en A kernel based classifier on a Riemannian manifold [10], donde los autores construyen un clasificador para un objetivo de dos clases con inputs soportadas sobre una variedad de Riemann. A tal fin, minimizan la pérdida 0-1 y siguen la regla de Bayes, de manera que su clasificador duro resulta:
(8)
que está de acuerdo con el estimador del clasificador de Bayes basado en densidad por núcleos para clases propuesto en la segunda parte cuando . En el caso más general con clases,
(9)
de modo que la tarea es equivalente a maximizar sobre . Si es la cantidad de observaciones en la clase y , podemos reescribir el estimador de densidad de la clase como:
(10)
como además , resulta que
(11)
Y suprimiendo la constante concluimos que la regla de clasificación resulta equivalente a:
(12)
para todo con un núcleo isotrópico con sucesión de ventanas [10, Ecuación 3.1]. Los autores toman de [11] la siguiente definición de consistencia:
Definición (consistencia de un clasificador [11, §6.1]). Sea una secuencia de clasificadores11 de modo que el -ésimo clasificador está construido con las primeras observaciones de la muestra . Sea la probabilidad de error de condicional a la muestra, y la que alcanza el clasificador de Bayes (ver segunda parte).
Diremos que la regla es (débilmente) consistente — o asintóticamente eficiente en el sentido del riesgo de Bayes — para cierta distribución si cuando
(13)
y fuertemente consistente si
(14)
En el trabajo, se prueba que el clasificador de Ecuación 12 es fuertemente consistente para .
Referencias
- [1] B. Pelletier, «Kernel Density Estimation on Riemannian Manifolds», Statistics & Probability Letters, vol. 73, n.º 3, pp. 297-304, jul. 2005, doi: 10.1016/j.spl.2005.04.004.
- [2] R. von Mises, «Uber Die" Ganzzahligkeit" Der Atomgewicht Und Verwandte Fragen», Physikal. Z., vol. 19, pp. 490-500, 1918.
- [3] R. A. Fisher, «Dispersion on a Sphere», Proceedings of the Royal Society of London. Series A. Mathematical and Physical Sciences, vol. 217, n.º 1130, pp. 295-305, 1957, doi: 10.1098/rspa.1953.0064.
- [4] K. V. Mardia, «Distribution Theory for the Von Mises-Fisher Distribution and Its Application», en A Modern Course on Statistical Distributions in Scientific Work, G. P. Patil, S. Kotz, y J. K. Ord, Eds., en NATO Advanced Study Institutes Series. Dordrecht: Springer Netherlands, 1975, pp. 113-130. doi: 10.1007/978-94-010-1842-5_10.
- [5] P. E. Jupp y K. V. Mardia, «A Unified View of the Theory of Directional Statistics, 1975-1988», International Statistical Review / Revue Internationale de Statistique, vol. 57, n.º 3, pp. 261-294, 1989, doi: 10.2307/1403799.
- [6] A. L. Muñoz, «Estimación no paramétrica de la densidad en variedades Riemannianas», Doctoral dissertation, 2011.
- [7] G. Henry y D. Rodriguez, «Kernel Density Estimation on Riemannian Manifolds: Asymptotic Results», Journal of Mathematical Imaging and Vision, vol. 34, n.º 3, pp. 235-239, jul. 2009, doi: 10.1007/s10851-009-0145-2.
- [8] A. L. Besse, Manifolds All of Whose Geodesics Are Closed. Berlin, Heidelberg: Springer Berlin Heidelberg, 1978. doi: 10.1007/978-3-642-61876-5.
- [9] C. Berenfeld y M. Hoffmann, «Density Estimation on an Unknown Submanifold», Electronic Journal of Statistics, vol. 15, n.º 1, pp. 2179-2223, ene. 2021, doi: 10.1214/21-EJS1826.
- [10] J.-M. Loubes y B. Pelletier, «A Kernel-Based Classifier on a Riemannian Manifold», Statistics & Decisions, vol. 26, n.º 1, pp. 35-51, mar. 2008, doi: 10.1524/stnd.2008.0911.
- [11] L. Devroye, L. Györfi, y G. Lugosi, A Probabilistic Theory of Pattern Recognition, Repr., n.º 31. en Applications of Mathematics. New York Berlin Heidelberg: Springer, 1996.