Distancia de Fermat · Parte 7 de 14
Distancias basadas en densidad y la distancia de Fermat
Distancias basadas en densidad
Algoritmos como Isomap aprenden la geometría de los datos, reemplazando la distancia euclídea ambiente por la distancia geodésica en el grafo pesado 1, que con converge a la distancia en . En estadística, conocer la geometría del soporte no es suficiente para tener un panorama completo. Por caso: sean y dos elementos aleatorios soportados en la esfera :
- surgido de muestrear uniformemente «coordenadas polares» en el rectángulo y proyectarlas a , y
- surgido de muestrear uniformemente directamente en .
Ambas distribuciones tienen la misma geometría, pero distintas densidades: se concentra en los polos y es mínimamente densa en el ecuador; es efectivamente igual de densa en todo .
Un ejemplo aún más concreto: sea la población de alumnos de nuestra facultad, y tomemos con
(1)
Es cierto que , pero resulta patente que la tasa de variación en ambas dimensiones no es la misma: una decena de años es una diferencia de edad significativa, mientras que una decena de cabellos faltantes es invisible a cualquiera2.
Conocer la densidad de los datos en la geometría es crucial para obtener una noción de distancia verdaderamente útil: de esta necesidad surge el estudio de las (métricas de) distancia basadas en densidad o «DBD»3: su premisa básica es computar la longitud de una curva integrando una función de costo inversamente proporcional a la densidad en — más «costosa» en regiones menos densas. Esta área del aprendizaje de distancias vio considerables avances durante el siglo XXI — luego del éxito empírico de Isomap —, y pavimentó el camino para técnicas de reducción de dimensionalidad basales en el «aprendizaje profundo»4 como los «autocodificadores»5. Yoshua Bengio — uno de los «padres de la IA» cuyo trabajo ya mencionamos en esta monografía —, menciona en Reddit cómo su grupo de investigación en la Universidad de Montreal trabajó en estas ideas: aprendizaje de variedades primero, y autocodificadores posteriormente.
El término hipótesis de la variedad es en efecto más antiguo que la revolución del aprendizaje profundo, aunque el concepto ya estaba presente en los primeros días de los autoencoders en los primeros años de los 90 (no bajo ese nombre, pero la misma idea) y los mapas autoorganizados en los 80, por no mencionar PCA aun antes (aunque eso estaba limitado a variedades lineales). Y el grupo a mi alrededor en la U. de Montreal en la década del 2000 y principios de la del 2010 trabajó bastante sobre el concepto, en el contexto de modelar distribuciones que se concentran cerca de un conjunto de menor dimensión (es decir, una variedad), por ejemplo, con denoising auto-encoders (trabajo liderado por Pascal Vincent) y contractive auto-encoders (liderado por Salah Rifai). También trabajamos en cómo la hipótesis de la variedad impactaba los modelos generativos y la dificultad de muestrear (y cómo muestrear) cuando hay múltiples variedades alejadas entre sí (el «problema de mezclado» en MCMC6).
— Y. Bengio
Aprender una DBD nos permite saltearnos el problema ya harto descrito de aprender la variedad desconocida , e ir directamente a lo único estrictamente necesario para tener un algoritmo de clasificación funcional: una noción de distancia adecuada.
P. Vincent y Y. Bengio [2] proveen una de las primeras heurísticas para una DBD: al igual que Isomap, toman las distancias de caminos mínimos pesados en un grafo con vértices , pero
- consideran el grafo completo en lugar del de -vecinos y
- pesan las aristas del grafo por la distancia euclídea en el espacio ambiente entre sus extremos elevada al cuadrado.
Esta noción de «distancia de arista-al-cuadrado»7 tiene el efecto de desalentar grandes saltos entre observaciones lejanas, que es una manera de «asignar un costo alto a trayectos por regiones de baja densidad», por lo cual ya califica como una DBD rudimentaria.
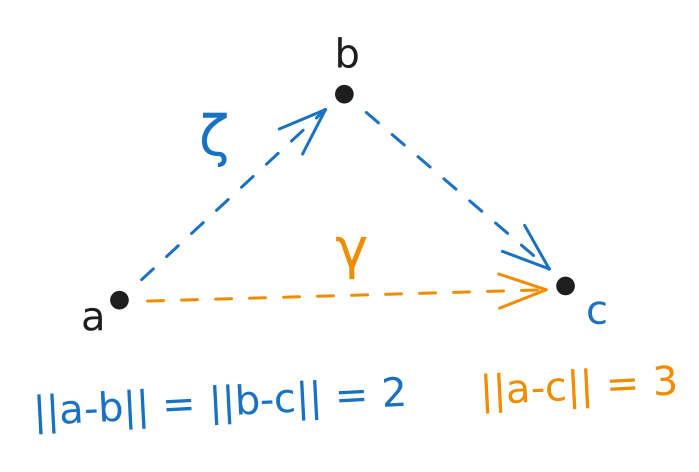
Consideremos el grafo geométrico de Figura 1. Con la norma euclídea, las longitudes definidas en la definición de longitud de una curva son
(2)
de modo que con geodésica . Con la distancia de arista-al-cuadrado,
(3)
y por lo tanto con geodésica . La distancia de arista-al-cuadrado cambia las geodésicas como también la escala en que se miden las distancias.
En las dos últimas décadas han surgido numerosos algoritmos para calcular DBD y hasta algunos surveys comparando las bondades relativas de cada una. L. Cayton [3] provee un resumen de los algoritmos de aprendizaje de variedades más relevantes hasta entonces. En sus reflexiones finales8, el autor considera que es tan amplio el espectro de variedades subyacentes y de representaciones «útiles» que se pueden concebir, que (a) en el plano teórico resulta muy difícil obtener garantías de eficiencia y rendimiento9, y (b) en el plano experimental, quedamos reducidos a elegir un conjunto representativo de variedades y observar si los resultados obtenidos son «intuitivamente agradables». Más aún, las evaluaciones experimentales requieren conocer la variedad subyacente para luego evaluar si el algoritmo de aprendizaje preserva información útil. Determinar si un dataset del mundo real efectivamente yace sobre cierta variedad es tan difícil como aprenderla; usar datos artificiales puede no rendir resultados realistas. Veintiún años más tarde, en esta monografía nos topamos con las mismas dificultades de antaño.
A nuestro entender, A. S. Bijral, N. Ratliff, y N. Srebro [4] ofrecen una de las primeras formalizaciones de qué constituye una DBD. Para abordarla, revisaremos una definición previa. En la cuarta parte definimos la longitud de una curva parametrizada y diferenciable sobre una variedad de Riemann compacta y sin frontera .
Definición (curva rectificable). Una curva rectificable es una curva que tiene longitud finita. Más formalmente, sea una curva parametrizada. La curva es rectificable si su longitud de arco es finita:
(4)
donde el supremo se toma sobre todas las particiones posibles del intervalo .
Equivalentemente, si es diferenciable por tramos, entonces es rectificable si y solo si:
(5)
Las curvas rectificables son importantes porque permiten definir conceptos como la longitud de arco y la parametrización por longitud de arco, que son fundamentales en geometría diferencial y análisis. En particular, sea una curva rectificable parametrizada y diferenciable por tramos y una función diferenciable. La «integral de línea»10 de sobre se define como:
(6)
donde representa el elemento de longitud de arco.
Si tiene longitud finita y es continua — como en nuestro caso de uso —, el resultado de la integral existe y es independiente de la parametrización.
Sea entonces un elemento aleatorio distribuido según sobre una variedad de Riemann compacta y sin frontera — potencialmente desconocida — . Sea además una función monótona decreciente en su parámetro. Consideraremos el «costo» de un camino entre como la integral de a lo largo de :
(7)
Y la distancia basada en la densidad pesada por entre dos puntos cualesquiera como
(8)
donde el ínfimo se toma respecto al conjunto de todos los senderos rectificables con extremos en , y es la -norma o distancia de Minkowski con parámetro .
Definición (norma ). Sea . Para , la norma 11 se define como:
(9)
Observación. Cada -norma induce su propia distancia . Algunas son muy conocidas:
- da la distancia «taxi» o «de Manhattan»12:
(10)
- da la distancia euclídea que ya hemos usado, omitiendo el subíndice :
(11)
- da la distancia de Chebyshev:
(12)
¿Es posible estimar de manera consistente? Intuitivamente, consideremos dos puntos 13 en un vecindario de lo «suficientemente pequeño» como para que sea esencialmente uniforme en él, y en particular en el segmento y tomemos :
donde .
Nótese que como ya mencionamos, tomar (o ) devuelve la distancia de Minkowski.
Sea una serie de índices identificando observaciones de . Luego, el costo de un paseo de pasos por el grafo completo de , , se puede computar con una simple suma:
(13)
Si es una muestra «suficientemente densa», los saltos entre nodos de índices consecutivos serán «cortos» y podemos estimar las distancias geodésicas como los «caminos mínimos» en el grafo completo de con aristas pesadas por .
Esta estimación es particularmente atractiva, en tanto no depende para nada de la dimensión ambiente, y solo depende de la dimensión intrínseca de a través de . De hecho, los autores mencionan que «casi cualquier par de valores funciona», y en particular encuentran que en sus experimentos, «anda bien en general» [4, §5.1]14.
Un resultado interesante por lo exacto aparece en T. Chu, G. L. Miller, y D. R. Sheehy [5]. Dado un conjunto de puntos , considérese la «métrica de vecino más cercano»
(14)
donde es un subconjunto de la variedad15 que da lugar a la función de costo
(15)
que a su vez define la distancia
(16)
que los autores llaman «distancia de vecino más cercano», .
Considérese además la distancia de arista-al-cuadrado16:
(17)
donde el ínfimo se toma sobre toda posible secuencia de puntos . Resulta entonces que la distancia de vecino más cercano y la métrica de arista cuadrada son equivalentes para todo conjunto de puntos en dimensión arbitraria [5, Teorema 1.1]17.
Probar la equivalencia para el caso trivial con se convierte en un ejercicio de análisis muy sencillo, que cimenta la intuición y explica el factor de en :
La demostración para
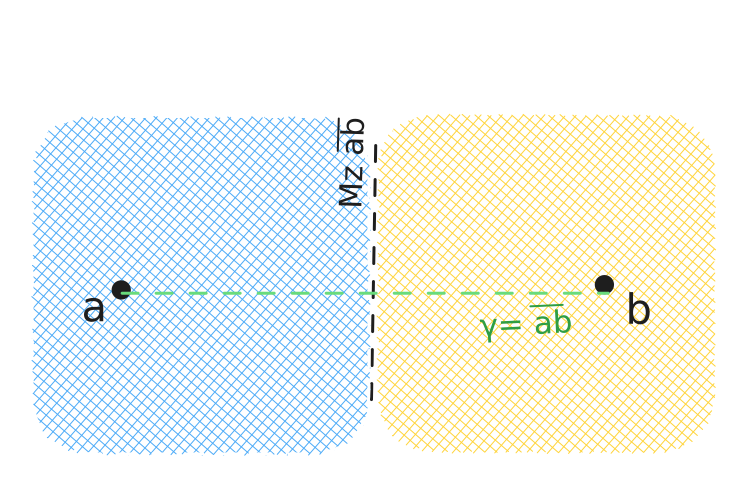
Con solo dos nodos, la geodésica de a es simplemente — cualquier otro camino repite nodos y se alarga innecesariamente —, así que . Ahora, requiere encontrar el mínimo entre todos los caminos posibles, aunque no viajen sobre las aristas del grafo. En la región azul, solo depende de la distancia a , y todo camino desde hasta la mediatriz debe recorrer al menos de esa distancia: el más barato es el segmento recto hasta el punto medio. Análogamente en la región naranja . Como todo camino de a cruza la mediatriz, el de menor costo es . Parametricémoslo:
(18)
(19)
El grueso del trabajo de Chu et al. consiste en una prueba general de esta igualdad, que se desarrolla en tres partes:
Para toda colección finita de puntos ,
1.a.
1.b.
- (1) también es válido para toda colección de compactos de .
Una utilidad de este resultado es que permite calcular con precisión para qué valores de estimar sobre el grafo pesado por aristas cuadradas es un «suficientemente buen reemplazo» del cálculo equivalente — pero mucho más costoso — sobre el grafo completo . En su Teorema 1.3, los autores observan que con tomar basta.
Lo que Chu et al. llaman y ya introdujimos como «distancia de arista-al-cuadrado» [2], [5], es la misma distancia que A. S. Bijral, N. Ratliff, y N. Srebro [4] consideran con (norma euclídea) y — de modo que .
Distancia de Fermat
No conocemos pruebas de equivalencia entre la familia de distancias de A. S. Bijral, N. Ratliff, y N. Srebro [4] y sus respectivas aproximaciones a través de geodésicas en el grafo completo para valores arbitrarios de y como la que acabamos de enunciar entre y , ni se desprende de la prueba mencionada que deban de existir. Sin embargo, sí existe en la literatura una familia de DBD para la cual se conocen tasas de convergencia asintótica de la aproximación muestral en el grafo completo a la distancia propiamente dicha, sobre una variedad riemanniana compacta sin frontera — la familia de Distancia(s) de Fermat.
P. Groisman, M. Jonckheere, y F. Sapienza [6] considera la misma familia de distancias basadas en funciones monótonamente decrecientes de la densidad que [4], , salvo que sus autores fijan y las parametrizan según
(20)
Los autores no se limitan a sugerir que la distancia en el espacio ambiente se puede aproximar a través de la distancia basada en el grafo completo con aristas pesadas, sino que precisan en qué sentido la una converge a la otra, y a qué tasa.18
Definición (Distancia «macroscópica» de Fermat [6, Definición 2.2]).
Sea una función continua y positiva, y . Definimos la Distancia de Fermat como:
(21)
donde el ínfimo se toma sobre el conjunto de todos los «senderos» o curvas rectificables entre e contenidos en — la clausura de —, y la integral se entiende con respecto a la longitud de arco dada por la distancia euclídea. Omitiremos la dependencia en y cuando no sea estrictamente necesaria.19
Este objeto «macroscópico» se puede aproximar a partir de una versión «microscópica» del mismo, que en el límite converge a :
Definición (Distancia muestral o «microscópica» de Fermat).
Sea un conjunto no vacío, localmente finito20 de . Para y , la Distancia Muestral de Fermat se define como
(22)
donde los . Nótese que satisface la desigualdad triangular, define una métrica sobre y una pseudométrica21 sobre .
Antes de presentar en qué sentido converge a , una definición más:
Teorema (Convergencia de , [6, Teorema 2.7]).
Asuma que es una variedad -dimensional isométrica embebida en y es una función de densidad de probabilidad continua. Sea un conjunto de elementos aleatorios independientes con densidad común . Entonces, para y tenemos:
(23)
donde es una constante que depende únicamente de y .
La distancia muestral de Fermat se puede aproximar a partir de una muestra «lo suficientemente grande» sin conocer ni la variedad ni su dimensión intrínseca. Además, tiene garantías de convergencia a una distancia basada en densidad (DBD) — la distancia de Fermat «macroscópica» — para todo . Hemos encontrado un candidato para la pieza faltante de nuestro clasificador en variedades desconocidas, y estamos finalmente en condiciones de proponer un algoritmo de clasificación que reúna todos los cabos del tejido teórico hasta aquí desplegado.
Trabajos contemporáneos a Groisman et al. [7], [8] analizan lo que ellos llaman «distancias de caminos mínimos pesadas por potencias»23, aplicándolas no a problemas de clasificación, sino de clustering24. Las definiciones de ambos grupos son muy similares en espíritu, con una diferencia: la distancia microscópica que plantean Little et al. no es la suma de las aristas pesadas por como en Bijral et al. y Groisman et al., sino la raíz -ésima de tal suma, en una especie de reversión de la distancia de Minkowski. Siendo la sustancia de estos trabajos muy similar a la de la distancia de Fermat pero aplicada a otro problema, no profundizaremos en ellos.
Referencias
- [1] Y. LeCun, Y. Bengio, y G. Hinton, «Deep Learning», Nature, vol. 521, n.º 7553, pp. 436-444, may 2015, doi: 10.1038/nature14539.
- [2] P. Vincent y Y. Bengio, «Density Sensitive Metrics and Kernels», en Proceedings of the Snowbird Workshop, 2003.
- [3] L. Cayton, «Algorithms for Manifold Learning», 2005.
- [4] A. S. Bijral, N. Ratliff, y N. Srebro, «Semi-Supervised Learning with Density Based Distances», en Proceedings of the Twenty-Seventh Conference on Uncertainty in Artificial Intelligence (UAI 2011), Arlington, Virginia: AUAI Press, 2011, pp. 43-50.
- [5] T. Chu, G. L. Miller, y D. R. Sheehy, «Exact Computation of a Manifold Metric, via Lipschitz Embeddings and Shortest Paths on a Graph», en Proceedings of the 2020 ACM-SIAM Symposium on Discrete Algorithms (SODA), en Proceedings., Society for Industrial and Applied Mathematics, 2019, pp. 411-425. doi: 10.1137/1.9781611975994.25.
- [6] P. Groisman, M. Jonckheere, y F. Sapienza, «Nonhomogeneous Euclidean First-Passage Percolation and Distance Learning», Bernoulli, vol. 28, n.º 1, feb. 2022, doi: 10.3150/21-BEJ1341.
- [7] A. Little, D. McKenzie, y J. M. Murphy, «Balancing Geometry and Density: Path Distances on High-Dimensional Data», SIAM Journal on Mathematics of Data Science, vol. 4, n.º 1, pp. 72-99, mar. 2022, doi: 10.1137/20M1386657.
- [8] D. Mckenzie y S. Damelin, «Power Weighted Shortest Paths for Clustering Euclidean Data», n.º arXiv:1905.13345. arXiv, septiembre de 2019.