Distancia de Fermat · Parte 6 de 14
Cuando la variedad es desconocida: aprender la distancia
La hipótesis de la variedad nos ofrece un marco teórico en el que abordar la clasificación en alta dimensión, y encontramos en la literatura que la estimación de densidad por núcleos en variedades de Riemann compactas sin frontera está estudiada y tiene buenas garantías de convergencia. Por alentador que resulte, ya notamos una primera dificultad — el cómputo de — y nos resta una segunda: la variedad que soporta las no suele ser conocida. Salvo que los datasets estén generados sintéticamente o el objeto de estudio cuente con un dominio bien entendido y ya formalizado, tendremos problemas tanto para definir adecuadamente la dimensión intrínseca como la distancia en .
Considere, por caso, el diagrama de Figura 2, la curva .
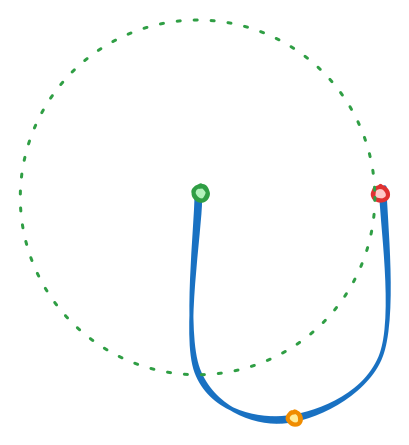
A los fines de estimar la densidad de soportada en cierta variedad , hace falta una noción de distancia apropiada en , pues como ya dijimos, raramente bastará con la propia del espacio ambiente.
En el ejemplo de Figura 2, con tan solo observaciones es imposible distinguir , pero con una muestra «suficientemente grande», es de esperar que los propios datos revelen la forma de la variedad. Sobre esta idea se edifica la teoría de «aprendizaje de distancias».
La distancia entre dos puntos es una representación útil de cuán similares son: a menor distancia, mayor similitud. Por ello, la estimación de variedades es fundamental al aprendizaje de representaciones. En una extensa reseña de dicho campo, [1] así lo explican:
La principal tarea del aprendizaje no supervisado se considera entonces como el modelado de la estructura de la variedad que sustenta los datos. La representación asociada que se aprende puede asociarse con un sistema de coordenadas intrínseco en la variedad embebida.
— [1, §8]
El ejemplo canónico: análisis de componentes principales (PCA)
El término «hipótesis de la variedad» es moderno, pero el concepto está presente hace más de un siglo en la teoría estadística2.
El algoritmo arquetípico de modelado de variedades es, como era de esperar, también el algoritmo arquetípico de aprendizaje de representaciones de baja dimensión: el Análisis de Componentes Principales, PCA [2], que dada , devuelve en orden decreciente las «direcciones de mayor variabilidad» en los datos, . Proyectar sobre las primeras direcciones,
(1)
nos devuelve la «mejor»3 representación lineal de dimensión .
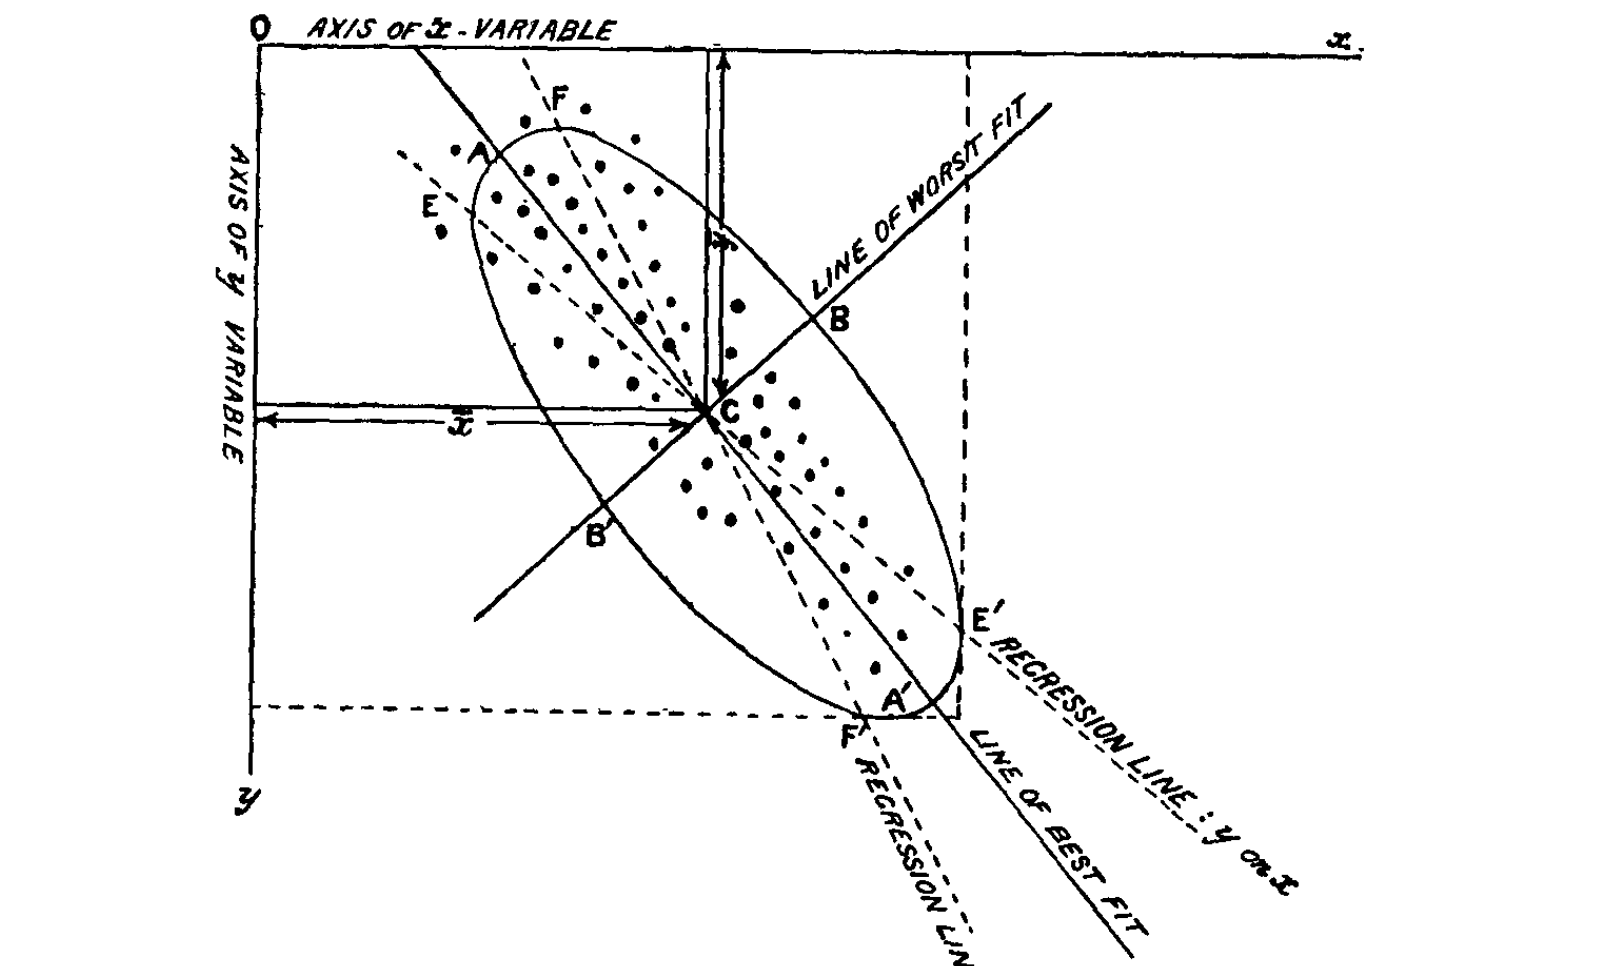
Ya se dijo que las variedades que soportan variables aleatorias «silvestres»4 seguramente sean fuertemente no lineales. Sin embargo, todavía hay lugar para PCA en esta aventura: cuando el dataset tiene dimensión verdaderamente muy alta, un proceso razonable consistirá en primero disminuir la dimensión a un subespacio lineal en que las distancias relativas sean casi idénticas a las del espacio original usando PCA, y recién en este subespacio aplicar técnicas más complejas de aprendizaje de distancias.
Aprendizaje del espacio tangente
Aprovechando que al menos las observaciones de entrenamiento son puntos conocidos de la variedad5, y que en la variedad el espacio es localmente euclídeo, P. Vincent y Y. Bengio [3] parten del estimador de densidad por núcleos multivariado (ver tercera parte) pero en lugar de utilizar un núcleo fijo en cada observación , se proponen hacer análisis de componentes principales en un vecindario de cada observación . En lugar de fijar un vecindario «duro» (de observaciones o radio ), definen un «vecindario suave» según , una medida de cercanía en el espacio ambiente tal como la densidad normal multivariada 6:
(2)
La estimación de densidad asociada resulta:
(3)
Ahora bien, computar una para cada una de las observaciones, más su inversa y la «raíz cuadrada» de esta última es muy costoso, por lo que los autores agregan un refinamiento: si la variedad en cuestión es de dimensión , es de esperar que las direcciones principales a partir de la -ésima sean «negligibles»7. En lugar de computar las componentes principales de ,
- fijan de antemano la dimensión esperada para la variedad,
- se quedan con las direcciones principales8,
- «ponen en cero» el resto y
- «completan» la aproximación con un poco de «ruido» .
La aproximación resultante — con los primeros autovectores y autovalores de — es mucho menos costosa de invertir, y tiene una interpretación geométrica bastante intuitiva en cada punto. Usando el mismo clasificador basado en la regla de Bayes que ya mencionamos en la segunda parte, obtienen así resultados superadores a los del KDE multivariado con . El método es intuitivo e ingenioso, pero todavía consta de dos dificultades:
- no es obvio cuál debería ser la dimensión intrínseca del paso (1) cuando la variedad es desconocida, y
- el subespacio generado por los primeros autovectores de la matriz de covarianza local a aproxima el espacio tangente , pero no dicen nada de cómo es en otros puntos.9
En un trabajo contemporáneo a [3], «Charting a Manifold» [8], el autor aborda dificultades análogas en el contexto de la reducción de dimensionalidad, en tres etapas:
- estimar la dimensión intrínseca de la variedad ; luego
- definir un conjunto de cartas centradas en cada observación que minimicen una divergencia global, y finalmente
- «coser» las cartas a través de una conexión global sobre la variedad.
El procedimiento para estimar es tanto ingenioso como costoso de computar. Sean observaciones -dimensionales muestreadas de una distribución en con con algo de ruido isotrópico10 -dimensional. Dada una bola centrada en un punto cualquiera , consideremos la tasa a la que incorpora observaciones vecinas a medida que crece . Cuando está en la escala del ruido isotrópico, la bola incorpora puntos rápidamente, pues los hay en todas las direcciones. A medida que alcanza la escala en la que la variedad es localmente análoga a , la incorporación de nuevos puntos disminuye, pues solo habrá nuevas observaciones en las direcciones tangentes a . Si sigue creciendo, la bola eventualmente alcanzará la escala de la curvatura de la variedad, momento en el que comenzará a acelerarse nuevamente la incorporación de puntos. El que minimiza identifica la escala localmente lineal, y la tasa de crecimiento en esa escala, la dimensión intrínseca: allí la cantidad de puntos en la bola crece como .11
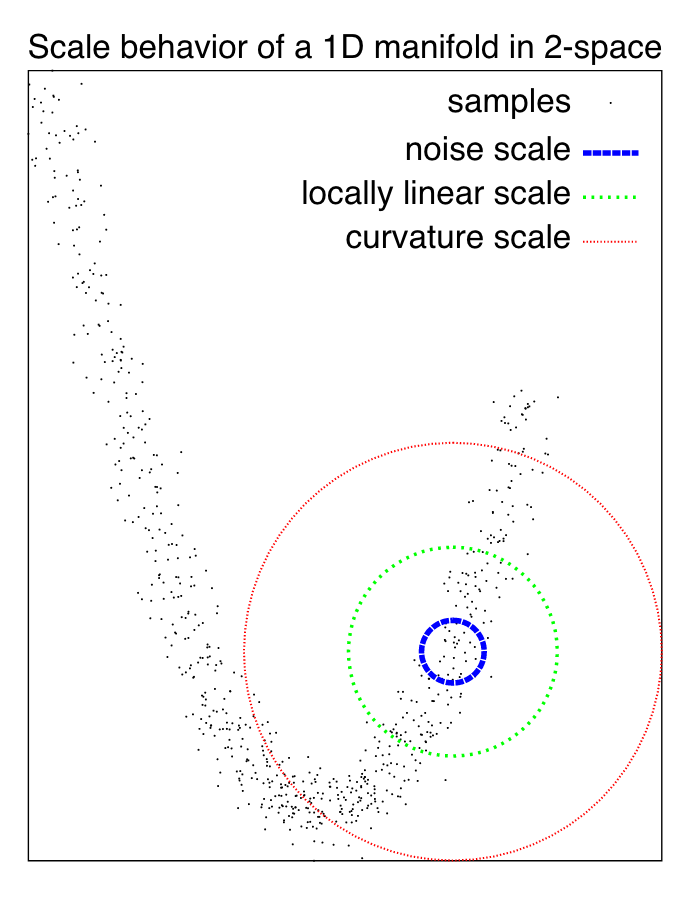
Estimada , los pasos siguientes no son menos complejos. Por un lado, se plantea un sistema de ecuaciones para obtener simultáneamente todos los entornos coordenados centrados en cada observación minimizando una medida de divergencia entre vecinos12. Finalmente, han de encontrar una conexión entre los entornos coordenados de cada observación, de manera que se puedan definir coordenadas para cualquier punto de la variedad y con ellas formar un atlas diferenciable.
Una conexión [9] es otro término de significado muy preciso en geometría riemanniana que aquí usamos coloquialmente. Es un objeto geométrico que conecta espacios tangentes cercanos, describiendo precisamente cómo estos varían a medida que uno se desplaza sobre la variedad. La «conexión» de Brand es más modesta: un conjunto de transformaciones afines que llevan las coordenadas locales de cada carta a un único sistema de coordenadas global en , resuelto en forma cerrada por mínimos cuadrados. El resultado es una representación de baja dimensión con mapas de ida y vuelta, del mismo tipo que las de Isomap o LLE13, pero no una métrica ni una densidad de volumen . Si se dispusiera de un atlas diferenciable con su conexión en sentido estricto, sería posible en principio computar y ; pero a esta altura, hemos reemplazado el de por sí difícil problema original — encontrar una buena representación de baja dimensión — por uno tal vez aún más difícil: encontrar la dimensión intrínseca, un atlas diferenciable y su conexión global para una variedad desconocida. El proceso es sumamente interesante, pero complejiza en lugar de simplificar nuestro desafío inicial.
Isomap
En rigor, no es necesario conocer para estimar densidades en ella; bastaría con conocer una aproximación a la distancia geodésica en que sirva de sustituto a la distancia euclídea en el espacio ambiente. Probablemente el algoritmo más conocido a tal fin sea Isomap — por «mapeo isométrico de features».
Desarrollado a fines del siglo XX por Joshua Tenenbaum et al. [10], [11], el algoritmo consta de tres pasos:
Definición (algoritmo Isomap). Sean observaciones -dimensionales. El mapeo isométrico de features es el resultado de:
Construir el grafo pesado de vecinos más cercanos , donde cada observación es un vértice y la arista14 que une con está presente con peso si y solo si
- (-Isomap): la distancia euclídea entre y en el espacio ambiente es menor o igual a , , o
- (-Isomap): es uno de los vecinos más cercanos de 15.
- Computar la distancia geodésica en el grafo — el «costo» de los caminos mínimos — entre todo par de observaciones, 16.
- Construir la representación -dimensional utilizando MDS17 en el espacio euclídeo que minimice una métrica de discrepancia denominada «estrés», entre las distancias de (2) y la norma euclídea en la representación. Para elegir el valor óptimo de , búsquese el «codo» en el gráfico de estrés en función de la dimensión de MDS18.
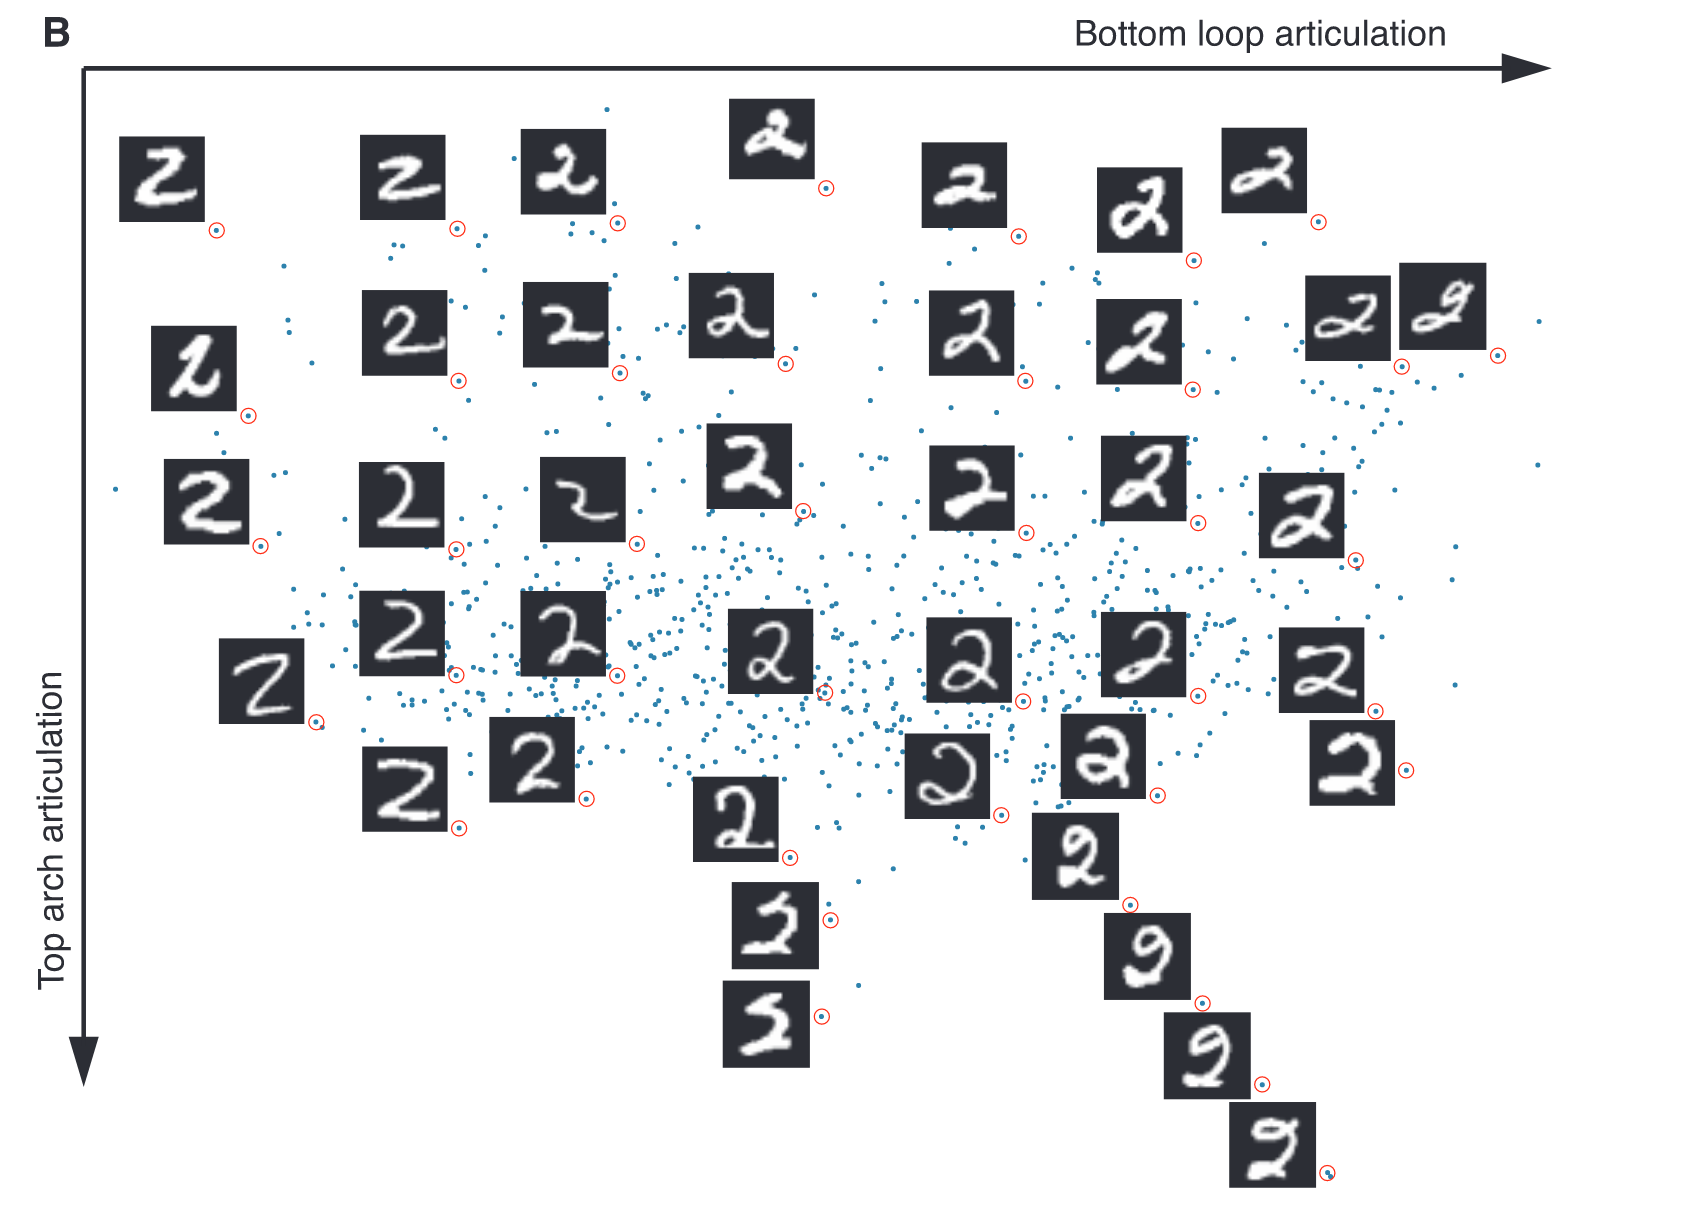
La pieza clave del algoritmo es la estimación de la distancia geodésica en a través de su aproximación por la distancia en el grafo de vecinos más cercanos. Si la muestra disponible es «suficientemente grande» y el espacio está «densamente muestreado», es razonable esperar que en el entorno de una observación las distancias euclídeas aproximen bien las distancias geodésicas, y por ende un «paseo» por el grafo debería describir una curva prácticamente contenida en . Isomap fue — y aún es — un algoritmo sumamente efectivo que avivó el interés por el aprendizaje de distancias, pero cuenta con un talón de Aquiles: la elección del parámetro de cercanía, o :
- valores demasiado pequeños pueden «partir» en más de una componente conexa, otorgando «distancia infinita» a puntos en componentes disjuntas, mientras que
- valores demasiado grandes pueden «cortocircuitar» la representación — en particular en variedades con muchos pliegues —, uniendo secciones de la variedad subyacente a través del espacio ambiente.
Referencias
- [1] Y. Bengio, A. Courville, y P. Vincent, «Representation Learning: A Review and New Perspectives», IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 35, n.º 8, pp. 1798-1828, ago. 2013, doi: 10.1109/TPAMI.2013.50.
- [2] K. Pearson, «LIII. On Lines and Planes of Closest Fit to Systems of Points in Space», nov. 1901, doi: 10.1080/14786440109462720.
- [3] P. Vincent y Y. Bengio, «Manifold Parzen Windows», en Advances in Neural Information Processing Systems, MIT Press, 2002.
- [4] T. Hastie, R. Tibshirani, y J. Friedman, Elements of Statistical Learning Data Mining, Inference, and Prediction. Springer London, Limited, 2009.
- [5] Y. Bengio, H. Larochelle, y P. Vincent, «Non-Local Manifold Parzen Windows», en Advances in Neural Information Processing Systems, MIT Press, 2005.
- [6] S. Rifai, Y. N. Dauphin, P. Vincent, Y. Bengio, y X. Muller, «The Manifold Tangent Classifier», en Advances in Neural Information Processing Systems, Curran Associates, Inc., 2011.
- [7] P. Simard, B. Victorri, Y. LeCun, y J. Denker, «Tangent Prop - A Formalism for Specifying Selected Invariances in an Adaptive Network», en Advances in Neural Information Processing Systems, Morgan-Kaufmann, 1991.
- [8] M. Brand, «Charting a Manifold», en Advances in Neural Information Processing Systems, MIT Press, 2002.
- [9] M. P. do Carmo, Riemannian Geometry. Birkhäuser Boston, 1992.
- [10] J. Tenenbaum, «Mapping a Manifold of Perceptual Observations», en Advances in Neural Information Processing Systems, MIT Press, 1997.
- [11] J. B. Tenenbaum, V. de Silva, y J. C. Langford, «A Global Geometric Framework for Nonlinear Dimensionality Reduction», Science, vol. 290, n.º 5500, pp. 2319-2323, dic. 2000, doi: 10.1126/science.290.5500.2319.
- [12] R. W. Floyd, «Algorithm 97: Shortest Path», Communications of the ACM, vol. 5, n.º 6, p. 345, jun. 1962, doi: 10.1145/367766.368168.
- [13] E. W. Dijkstra, «A Note on Two Problems in Connexion with Graphs», Numerische Mathematik, vol. 1, n.º 1, pp. 269-271, dic. 1959, doi: 10.1007/BF01386390.
- [14] J. B. Kruskal, «Multidimensional Scaling by Optimizing Goodness of Fit to a Nonmetric Hypothesis», Psychometrika, vol. 29, n.º 1, pp. 1-27, mar. 1964, doi: 10.1007/BF02289565.