Distancia de Fermat · Parte 3 de 14
La maldición de la dimensionalidad y la hipótesis de la variedad
En la segunda parte estimamos densidades de una variable . ¿Qué pasa cuando tiene muchas componentes?
Naive Bayes
Una manera «ingenua» de adaptar el procedimiento de estimación de densidad ya mencionado a multivariadas consiste en sostener el falso-pero-útil supuesto de que sus componentes son independientes entre sí. De este modo, la estimación de densidad conjunta se reduce a la estimación de densidades marginales univariadas. Dada cierta clase 1, podemos escribir la densidad condicional como
(1)
donde es la densidad de condicional a la clase . Este procedimiento se conoce como «Naive Bayes» [1, §6.6.3], y a pesar de su aparente ingenuidad es competitivo contra algoritmos mucho más sofisticados en un amplio rango de tareas. En términos de cómputo, permite resolver la estimación con KDE univariados. Además, permite que en se combinen variables cuantitativas y cualitativas: basta con reemplazar la estimación de densidad para las componentes cualitativas por su correspondiente histograma.
KDE multivariado
Consideremos un dataset compuesto por observaciones muestreadas de dos círculos concéntricos con algo de ruido:
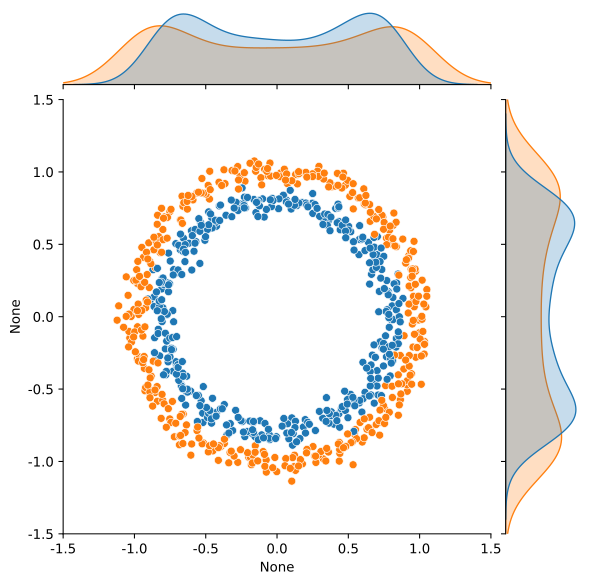
En casos así, el procedimiento de Naive Bayes falla por completo, y será necesario adaptar el procedimiento de KDE unidimensional a sin basarnos en el supuesto de independencia de las . A lo largo de las cuatro décadas posteriores a las publicaciones de Parzen y Rosenblatt, el estudio de los estimadores de densidad por núcleos avanzó considerablemente, de manera que ya para mediados de los '90 existían minuciosos libros de referencia como «Kernel Smoothing» [2], que seguiremos en la presente sección.
Definición (KDE multivariada, [2, §4]). En su forma más general, el estimador de densidad por núcleos -variado es
(2)
donde
- es una matriz simétrica definida positiva análoga a la ventana para ,
- y
- es una función núcleo -variada tal que .
Típicamente, es la densidad normal multivariada estándar
(3)
La elección de
Sean las siguientes clases de matrices de :
- , de matrices simétricas definidas positivas,
- , de matrices diagonales definidas positivas () y
- , de múltiplos escalares de la identidad: .
Aun tomando una única para toda la muestra, la elección de en dimensiones requiere ajustar
- parámetros si ,
- parámetros si y
- un único parámetro si .
La evaluación de la conveniencia relativa de cada parametrización se vuelve muy compleja, muy rápido. M. P. Wand y M. C. Jones [3] proveen un análisis detallado para el caso , y concluyen que aunque cada caso amerita su propio estudio, suele ser un compromiso «adecuado» entre la complejidad de tomar y la rigidez de . Sin embargo, este no es un gran consuelo para valores de verdaderamente altos, en cuyo caso existe aún un problema más fundamental.
La maldición de la dimensionalidad
Uno estaría perdonado por suponer que el problema de estimar densidades en alta dimensión se resuelve con una buena elección de , y una muestra «lo suficientemente grande». Considérese, sin embargo, el siguiente ejercicio ilustrativo de cuánto es «suficientemente grande»:
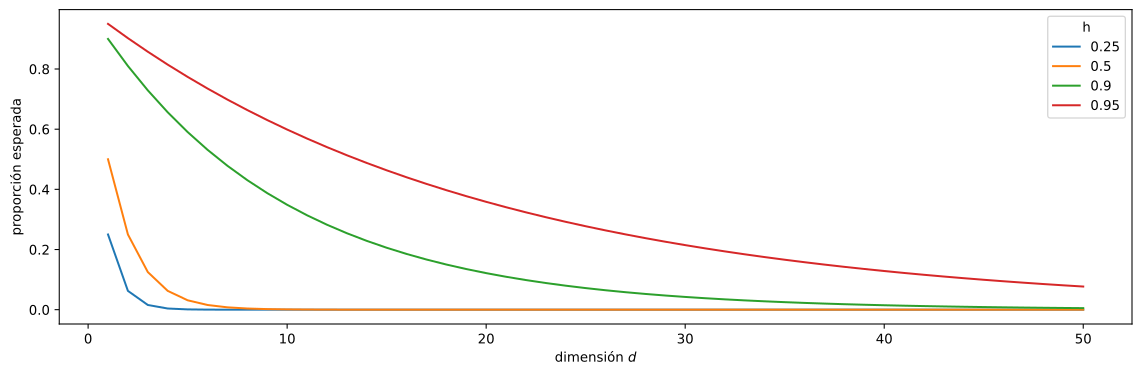
Sean , y consideremos la estimación de la densidad en el origen, . Suponga que el núcleo es un «núcleo producto» basado en la distribución univariada , y . Derive una expresión para la proporción esperada de puntos incluidos dentro del soporte del núcleo para arbitrarios.
— adaptado de [2, §4.9, ej. 4.1]
La cuenta: qué proporción de la muestra cae dentro del núcleo
El «núcleo producto» -variado basado en cierta ley univariada no es más que el producto de densidades univariadas como aquella. Para la el núcleo evaluado en el origen es:
(4)
De la definición de KDE multivariada y el hecho de que , se sigue que
(5)
De modo que . Como la distribución de las es uniforme en su dominio, su densidad es constante y la proporción esperada de puntos es una simple proporción:
(6)
Para , ¡menos de uno en un millón! Dicho de otra forma: en 20 dimensiones, una «cajita» con la mitad del ancho de otra contiene menos de una millonésima de su volumen. Aun para , en verdaderamente altas dimensiones el fenómeno es dramático. Represente un segundo de audio, muestreado respetando el estándar mínimo para llamadas telefónicas2, tal que . En tal espacio ambiente, aun con , , o 1:3.000.
La hipótesis de la variedad (manifold hypothesis)
Ahora, si el espacio está tan, pero tan vacío en alta dimensión, ¿cómo es que el aprendizaje supervisado sirve de algo? La reciente explosión en capacidades y herramientas de procesamiento (¡y generación!) de formatos de altísima dimensión3 pareciera ser prueba fehaciente de que la tan mentada maldición de la dimensionalidad no es más que una fábula para asustar estudiantes de estadística.
Pues bien, el ejemplo de un segundo de audio antedicho es sesgado: no es cierto que si representa un segundo de voz humana digitizada, su ley sea uniforme en 8000 dimensiones4. Un segundo de audio generado siguiendo cualquier distribución en la que muestras consecutivas no tengan ninguna correlación da por resultado ruido blanco. La voz humana tiene estructura, y por ende correlación instante a instante. Cada voz tiene un timbre característico, y las posibles palabras a enunciar están ceñidas por la estructura fonológica de la lengua locutada.
Sin precisar detalles, podríamos postular que las realizaciones de la variable de interés (el habla), que registramos en un soporte de alta dimensión, en realidad se concentran en cierta variedad5 de potencialmente mucha menor dimensión , con una noción de distancia más «útil» que la de . A tal postulado se lo conoce como «la hipótesis de la variedad», o manifold hypothesis.6
La hipótesis de la variedad no es exactamente una hipótesis contrastable en el sentido tradicional del método científico; de hecho, ni siquiera resulta obvio que de existir, sean susceptibles de definición las variedades en las que existen los elementos del mundo real: un dígito manuscrito, el canto de un pájaro, o una flor. Y de existir, es de esperar que sean altamente no lineales. Más bien, corresponde entender esta hipótesis como un modelo mental, que nos permite aventurar ciertas líneas prácticas de trabajo en alta dimensión.7
Antes de poder profundizar en esta línea, debemos plantearnos algunas preguntas básicas:
¿Qué es exactamente una variedad?
¿Se pueden construir KDE con soporte en variedades?
¿Y si la variedad es desconocida?
Referencias
- [1] T. Hastie, R. Tibshirani, y J. Friedman, Elements of Statistical Learning Data Mining, Inference, and Prediction. Springer London, Limited, 2009.
- [2] M. P. Wand y M. C. Jones, Kernel Smoothing. Boston, MA: Springer US, 1995. doi: 10.1007/978-1-4899-4493-1.
- [3] M. P. Wand y M. C. Jones, «Comparison of Smoothing Parameterizations in Bivariate Kernel Density Estimation», Journal of the American Statistical Association, vol. 88, n.º 422, pp. 520-528, jun. 1993, doi: 10.1080/01621459.1993.10476303.
- [4] S. Rifai, Y. N. Dauphin, P. Vincent, Y. Bengio, y X. Muller, «The Manifold Tangent Classifier», en Advances in Neural Information Processing Systems, Curran Associates, Inc., 2011.
- [5] V. Gallese, «The Roots of Empathy: The Shared Manifold Hypothesis and the Neural Basis of Intersubjectivity», Psychopathology, vol. 36, n.º 4, pp. 171-180, sep. 2003, doi: 10.1159/000072786.
- [6] Y. Bengio, «The Consciousness Prior», n.º arXiv:1709.08568. arXiv, diciembre de 2019.